IT之家 11 月 3 日消息,来自麻省理工学院计算机科学与人工智能实验室(MIT CSAIL)的科研人员提出了一项名为「权重空间编程」(Weight-Space Programming)的创新技术。
他们借助 OpenAI 的 GPT-6 Astra,直接对阿里云通义千问旗下热门模型 Qwen3.5-0.8B 的神经网络权重进行分析与调整,仅修改了大约 0.016% 的参数,便使得该模型在 MATH-500 数学测评中的得分从 7.9% 跃升至 48.1%,相当于提升了近 6.1 倍。据称,整个流程未涉及梯度下降或传统训练步骤。
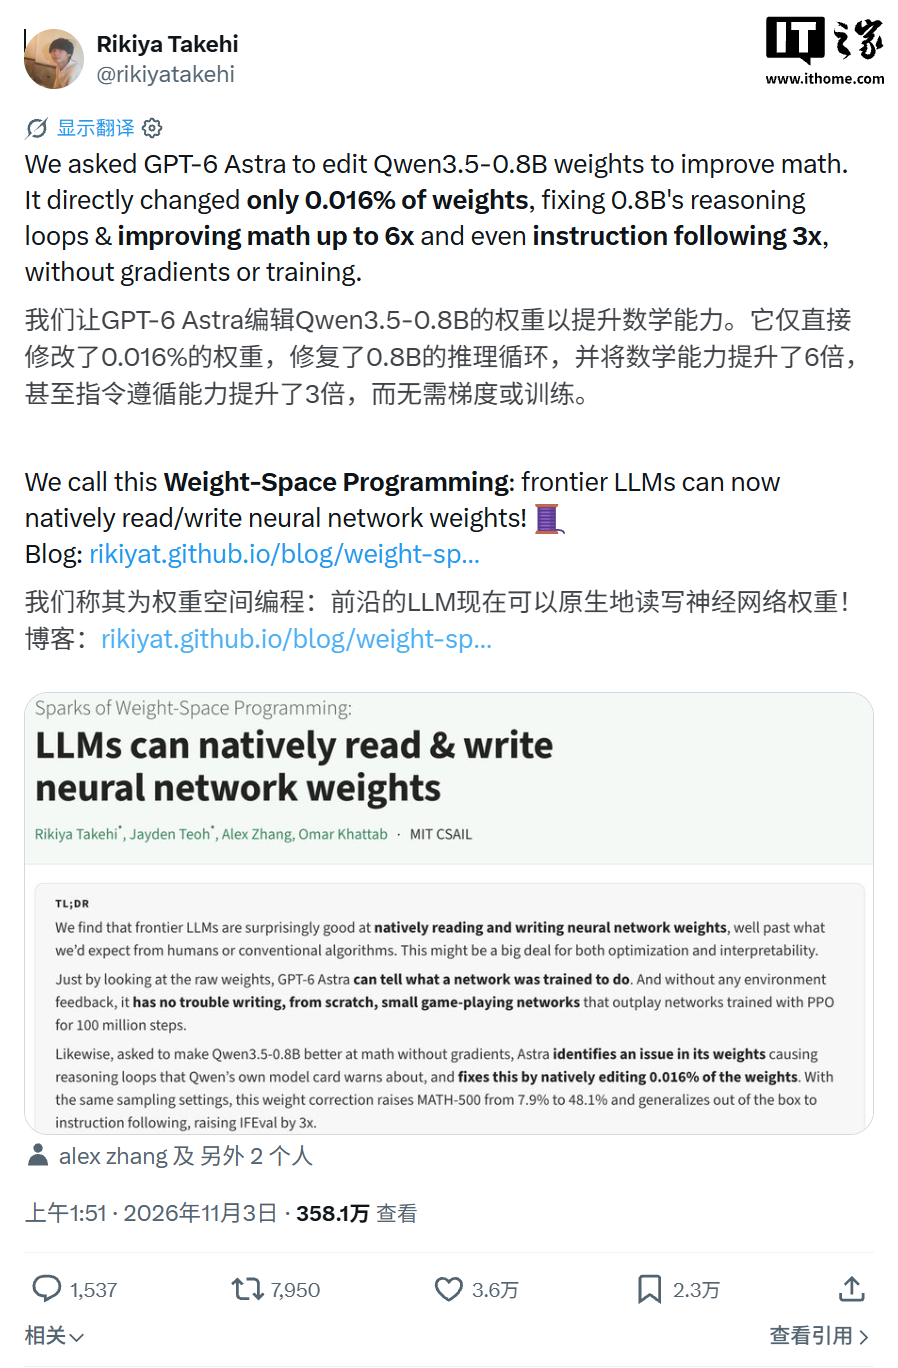
这项研究由 Rikiya Takehi、Jayden Teoh、Alex Zhang 和 Omar Khattab 联手完成。Takehi 于当地时间 11 月 2 日通过博客发布了这一成果,将其命名为「权重空间编程」,核心理念是让大语言模型直接读取、理解并修改另一神经网络的权重,而非通过常规训练流程来调整参数。
在具体实验中,GPT-6 Astra 并非简单地对少量参数进行随机调整,而是先识别出 Qwen3.5-0.8B 在推理过程中的问题。
研究人员发现,该模型在解答数学问题时容易陷入重复生成相同内容的循环,导致大量回答耗尽了 32768 个 Token 的长度限制。在最初的 96 次测试回答中,有 85 次达到了这一上限。
研究团队为 GPT-6 Astra 提供了一个能够读取和修改模型权重的 Python 环境,并允许其利用 GSM8K 和 MATH 训练集中的练习题进行有限次数的前向推理。随后,Astra 定位到第 15 层和第 19 层 MLP(多层感知机)中写入的一种重复方向,通过调整这两层的部分权重,削弱了导致推理循环的信号。
最终,Astra 修改了 131072 个权重,占 Qwen3.5-0.8B 约 8 亿个参数的 0.016%。在允许进行 50 轮前向推理的实验中,模型在 MATH-500 上的成绩从 7.9% 提升至 48.1%,在 GSM8K 上从 13.8% 提升至 67.1%。
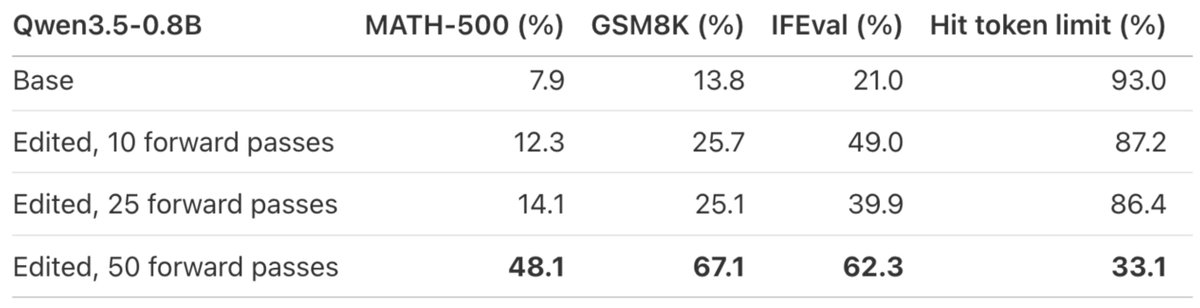
此外,修改后的模型在指令遵循能力上也有所增强。在衡量模型指令遵循表现的 IFEval 测试中,修改后的模型得分从 21.0% 提升至 62.3%,约为原来的 3 倍。同时,在数学测试中因生成长度达到上限而无法完成回答的比例,从原来的 93% 降至 33.1%。
需要指出的是,这项实验并非完全没有计算过程。GPT-6 Astra 使用了 Python 环境来分析和修改权重,并进行了最多 50 轮前向推理,只是没有采用梯度下降、反向传播或传统训练循环来更新参数。
研究人员还使用 Gemma 3 270M 进行了对照实验。由于该模型原本很少出现推理循环,Astra 无法通过类似的局部权重修改显著提升其数学能力,MATH-500 成绩最多仅从 6.8% 提升至 7.7%。研究团队据此指出,权重空间编程可以消除模型在发挥已有能力时遇到的障碍,但未必能凭空创造模型原本不具备的能力。
这项研究还包含其他实验,例如让 GPT-6 Astra 仅通过读取神经网络权重来识别模型训练过的游戏、判断小型语言模型的训练语言,以及直接编写能够运行游戏的神经网络。研究人员认为,这种方法有望为神经网络可解释性研究和模型优化提供新的思路。
参考资料:
- 《Sparks of Weight-Space Programming: LLMs can natively read & write neural network weights》
爱游戏网页服务以初次访问与深度查找均有对应路径,减少重复浏览时间。为核心,带来高效便捷的体验。
爱游戏网页服务深耕涵盖平台概览、栏目说明、操作指南与常见问题四大模块。领域,用心服务每一位用户。
想了解更多爱游戏体育网站相关内容,尽在爱游戏网页服务。
在结合公告与更新说明,帮助用户理解网页功能间的关联。方面,爱游戏网页服务提供贴心周到的支持。
爱游戏网页服务围绕爱游戏内容分类不断创新,回应用户的真实需求。
爱游戏网页服务以初次访问与深度查找均有对应路径,减少重复浏览时间。为核心,带来高效便捷的体验。
精选爱游戏网页服务内容,爱游戏网页服务与你一同发现更多精彩。
想了解更多爱游戏体育网站相关内容,尽在爱游戏网页服务。